私人AI配音工作站
基于 CosyVoice3、小米 MiMo 与阿里 Qwen3-TTS 三大引擎,集高保真声音克隆、Qwen3 声音设计、多角色配音管理与批量导出于一体。 本地离线运行,隐私数据不出本机,让配音效率提升 10 倍。
核心功能
从音色生成到成品导出,一套工作流覆盖配音全流程
高保真音色克隆
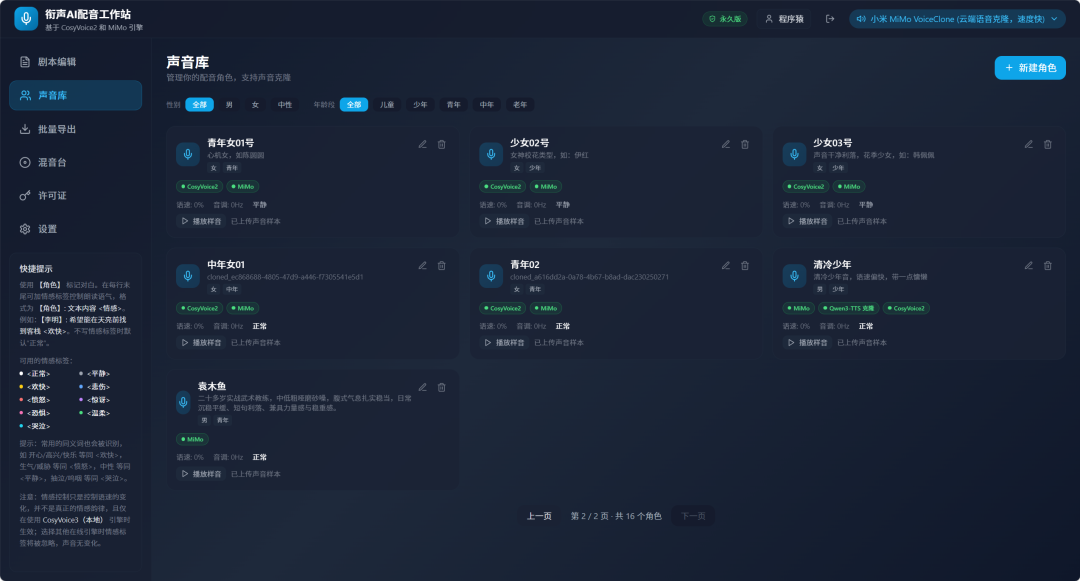
角色创建的两种方式之一:上传 15–30 秒参考音频,即可精准复刻人物音色。可同时多选引擎克隆(CosyVoice3 需提供精确样音文字,小米 MiMo 免文字直接克隆),支持预览试听与删除片段裁剪,本地离线运行、音色数据不出本机。
- 上传 15–30 秒 MP3/WAV 参考音频
- 可多选引擎同时克隆(CosyVoice3 / MiMo)
- 预览试听 + 删除片段裁剪瑕疵
- 本地离线,音色数据不出本机
用一句话生成全新音色
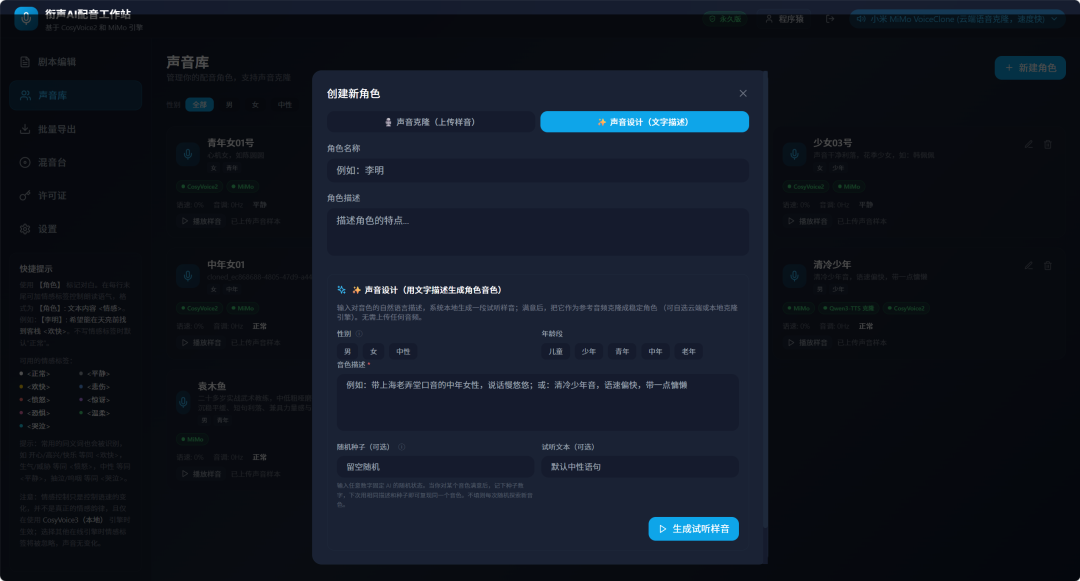
角色创建的另一种方式:无需任何参考音频。用自然语言描述声线(如「带上海老弄堂口音的中年女性,说话慢悠悠」),并可加性别/年龄段硬约束与随机种子(同描述同种子可复现同一音色),本地生成试听样音,满意后一键克隆固化到云端或本地引擎。
- 自然语言描述即可生成音色,零素材
- 性别/年龄段硬约束,避免性别错乱
- 随机种子固定,满意音色可复现
- 本地免费、CPU 即可,确认后一键克隆
多角色配音管理
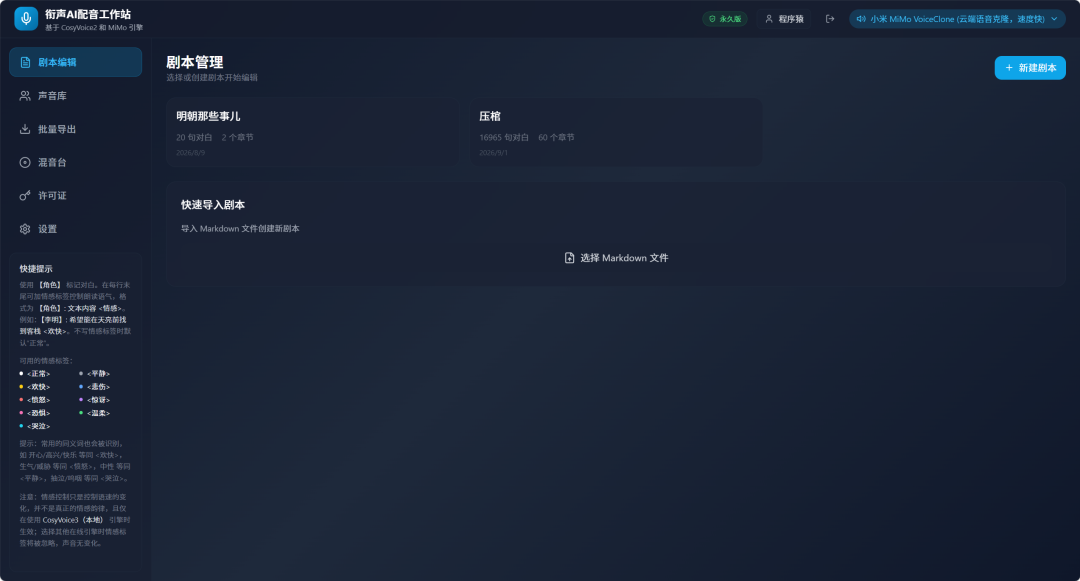
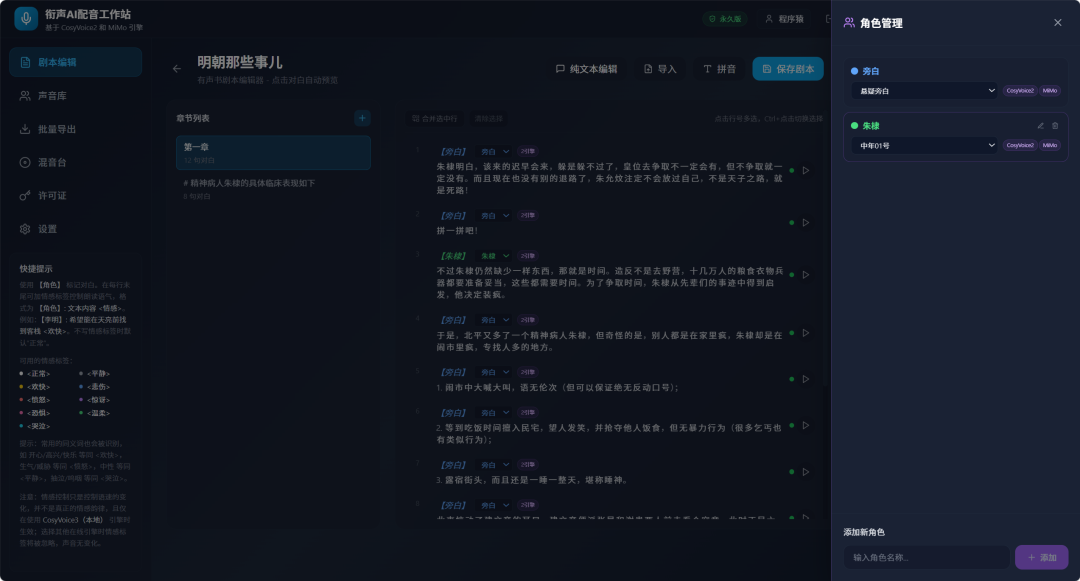
在剧本编辑器里按章节组织内容,支持对话内容智能识别与文本行智能拆分,自动把长文本按角色和语义拆成逐句对白。每行可直接绑定说话角色、标注行内情感,并配套完善的字音与配音能力,让长篇有声书也能高效产出。
- 对话内容智能识别,自动提取角色与对白
- 智能拆分文本行,按语义与角色自动断句
- 文本行角色绑定,逐句指定谁在说
- 行内情感标签 <欢快> <愤怒>,逐句控情绪
- 多音字点击纠音 + 手动拼音,合成读音更准
- 章节级 [BGM] 指令:淡入、音量、循环
- 旁白可绑角色音;导入 Markdown 批量建剧
批量导出,一键交付
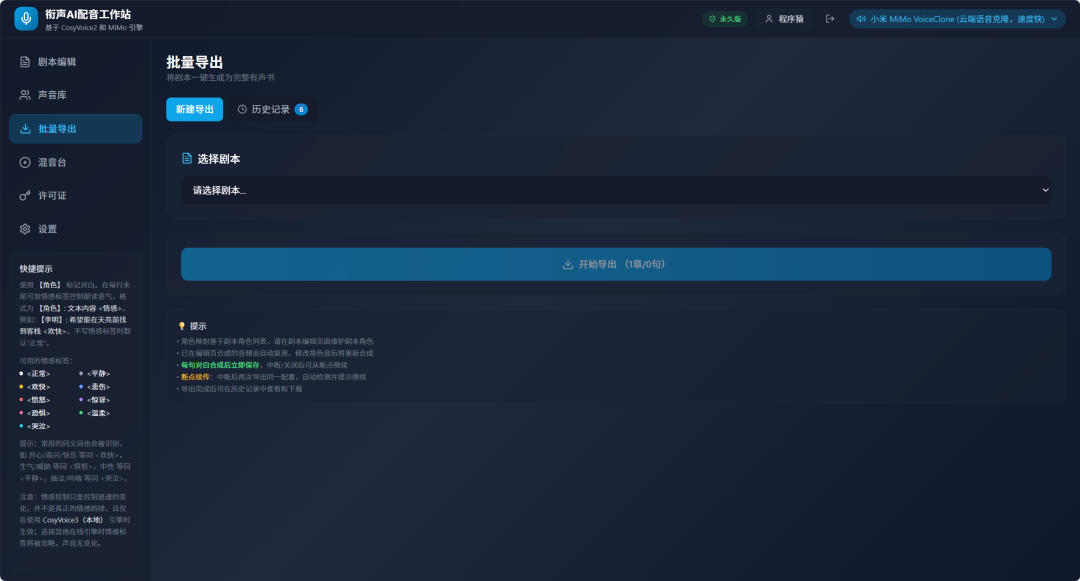
把剧本一键合成为带包装的成品音频。先为各角色映射配音声音,再配置片头、背景音乐与片尾,即可导出完整的音频文件。
- 片头/片尾三模式:仅音频/仅文本TTS/音频+文本混音
- 背景音乐:衰减量、淡入淡出、自适应闪避、循环
- 逐句断点续传,中断后从断点继续
- 导出 WAV / MP3,附细粒度进度与历史记录
专业混音台,让配音像做音乐一样精细
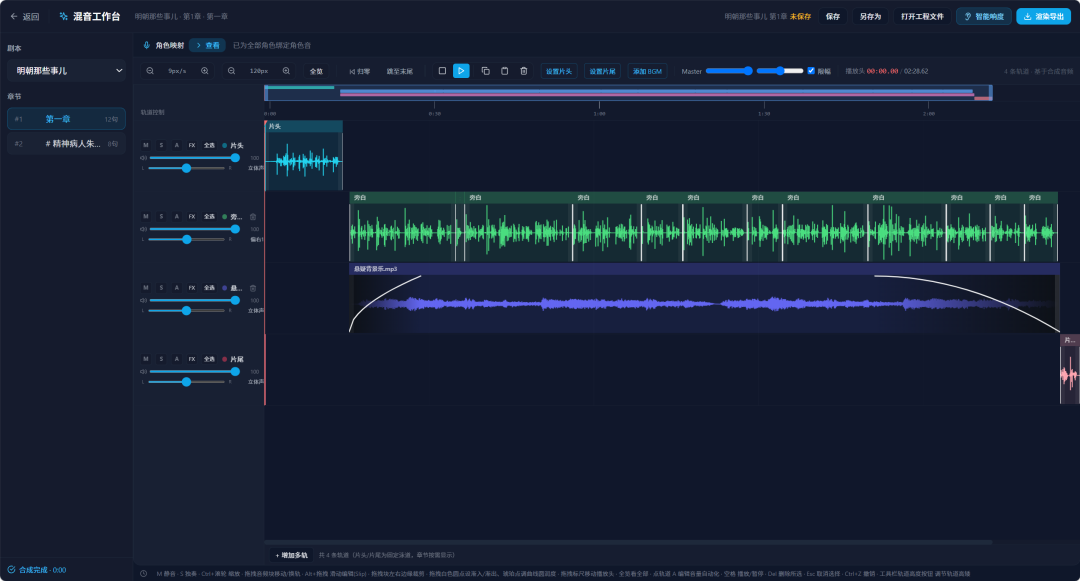
不再满足于干声直出。衔声混音台把每条角色语音、背景音乐、音效放到独立轨道,支持包络线、闪避、声像、静音/独奏与实时预览,让你在一个界面内完成从配音到成品的全部精修。
- 多轨时间线:角色语音轨、BGM 轨、音效轨独立拖拽与对齐
- 音量包络线:逐句/逐段绘制音量起伏,精细控制情绪强弱
- 智能闪避:检测到人声自动压低背景音,无需手动画线
- 淡入淡出:每个片段独立设置渐入渐出时长,过渡自然
- 声像 Pan:左右声道平衡控制,营造空间感与对话方位
- 静音 / 独奏:快速对比单轨效果,排查问题更高效
- 实时预览:边调边听,参数改动即时生效
- 非破坏性编辑:原始合成音频不被覆盖,随时回退重做
- 章节级 BGM 指令:在剧本里写 [BGM] 即可自动控制音乐切入/淡出/循环
- 一键导出成品:混音完成后直接输出 WAV / MP3,无需切换工具
角色创建的两种方式
无论你想复刻自身真实声音,还是凭空创造一条全新声线,衔声都给你最短路径。 两种方式共用同一套角色库,随时切换、自由组合。
声音克隆
已有目标声音?上传一段参考音频,精准复刻其音色。适合需要特定人物原声的场景。
- 上传 15–30 秒 MP3 / WAV 参考音频
- 可多选引擎同时克隆(CosyVoice3 / 小米 MiMo)
- 预览试听 + 删除片段,裁剪瑕疵更干净
- 本地离线运行,音色数据不出本机
Qwen3 声音设计
没有参考音频?用一句话描述你想要的声线,凭空生成。适合需要虚构角色或批量试音的场景。
- 自然语言描述即可生成音色,零素材门槛
- 性别 / 年龄段硬约束,避免性别错乱
- 随机种子固定,满意音色可精准复现
- 本地免费、CPU 即可,确认后一键克隆固化
两种方式生成的声音都会进入同一角色库,在剧本编辑器里按需分配给不同角色,自由混用。
三大引擎体系
离线克隆、在线扩展、文本设计,按需组合
CosyVoice3
阿里通义实验室开源
本地离线高保真音色克隆引擎,支持情感指令控制。数据不出本机,隐私安全,离线可用。
小米 MiMo 在线
MiMo 开放平台
云端语音克隆引擎,配置个人 API Key 即可灵活使用,提供更多声音选择与在线算力。
Qwen3-TTS
阿里通义千问
同时承载声音设计与本地克隆:声音设计凭自然语言描述生成全新音色,本地克隆免费高保真,CPU 即可运行。
五步完成专业配音
从文本到成品,工作流清晰顺畅
撰写文本
在客户端导入或编写剧本,按角色分段。
设计 / 克隆音色
用 Qwen3 声音设计凭描述生成,或上传参考音频克隆。
多角色合成
为角色分配音色,一键生成高质量语音。
混音台精修
在多轨混音台里调整音量、闪避、淡入淡出与声像。
批量导出
导出 WAV / MP3,交付你的作品。
常见问题
关于产品、隐私与平台支持的解答
我的音频数据安全吗?+
本地离线引擎(CosyVoice3、Qwen3-TTS)在你的设备上运行,音色与音频数据不出本机。仅在配置并使用小米 MiMo 在线引擎时,才会将必要数据发送至对应的开放平台。
支持哪些操作系统?+
目前客户端已支持 Windows 平台;macOS 版本正在筹备中,敬请期待。
声音克隆需要多长的参考音频?+
一般上传约 10 秒清晰、无明显噪声的参考音频即可获得高质量克隆效果,音频越干净、情绪越贴合,效果越好。